LinkedHashSet和LinkedHashMap源码剖析
总体介绍
LinkedHashSet和LinkedHashMap在Java里也有着相同的实现,前者仅仅是对后者做了一层包装,也就是说LinkedHashSet里面有一个LinkedHashMap(适配器模式)。
LinkedHashMap实现了Map接口,即允许放入 key 为 null 的元素,也允许插入 value 为 null 的元素。从名字上可以看出该容器是LinkedList和HashMap的混合体,也就是说它同时满足HashMap和LinkedList的某些特性。可将LinkedHashMap看作采用LinkedList增强的HashMap。
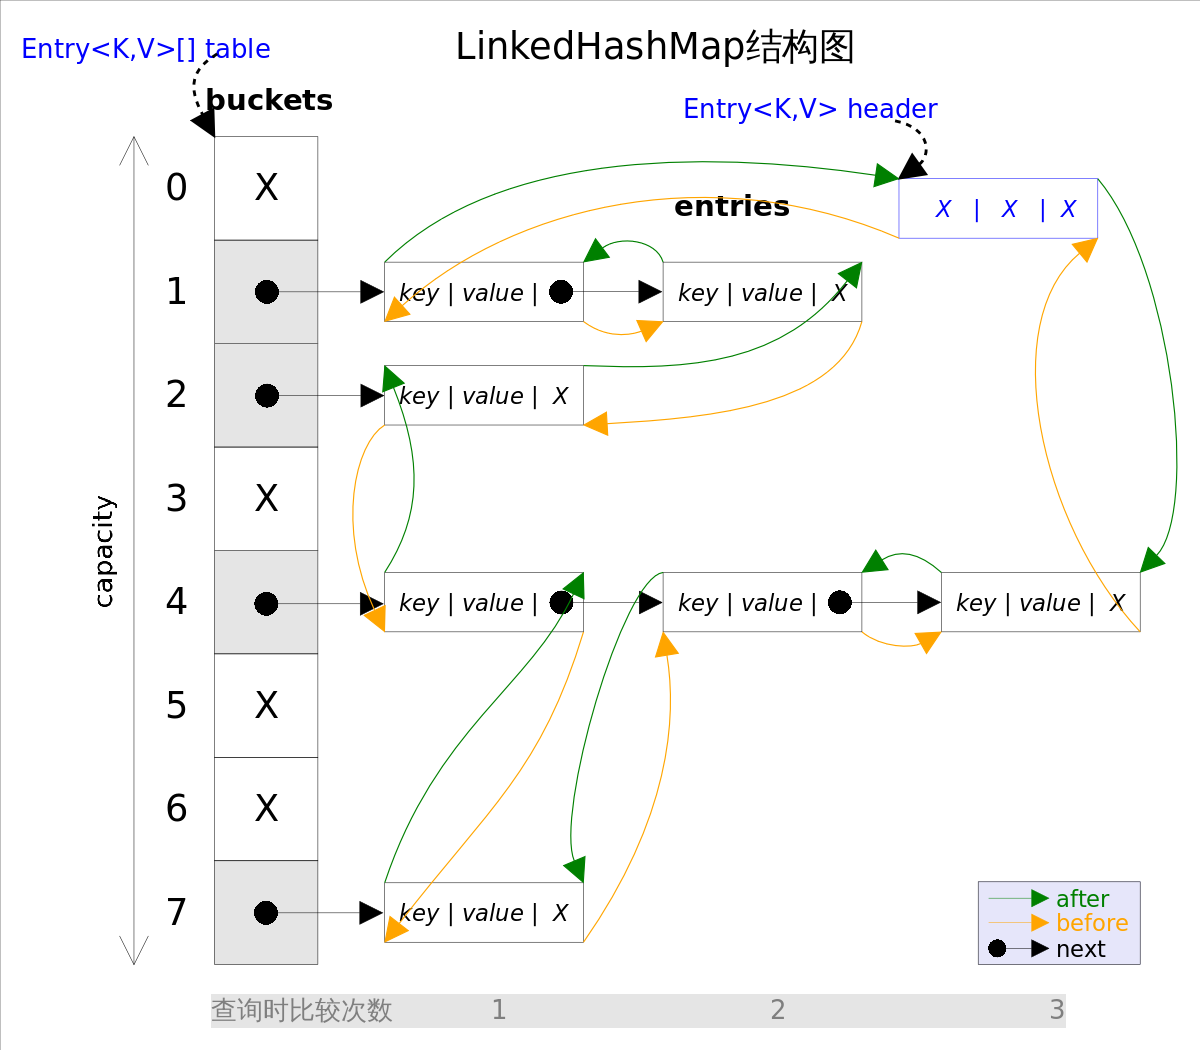
1 | private transient Entry<K,V> header; |
1 | private static class Entry<K,V> extends HashMap.Entry<K,V> { |
事实上LinkedHashMap是HashMap的直接子类,二者唯一的区别是LinkedHashMap在HashMap的基础上,采用双向链表(doubly-linked list)的形式将所有 entry 连接起来,这样是为保证元素的迭代顺序跟插入顺序相同。上图给出了LinkedHashMap的结构图,主体部分跟HashMap完全一样,多了 header 指向双向链表的头部(是一个哑元),该双向链表的迭代顺序就是 entry 的插入顺序。
除了可以保证迭代顺序,这种结构还有一个好处:迭代LinkedHashMap时不需要像HashMap那样遍历整个 table ,而只需要直接遍历 header 指向的双向链表即可,也就是说LinkedHashMap的迭代时间就只跟 entry 的个数相关,而跟 table 的大小无关。
有两个参数可以影响LinkedHashMap的性能:初始容量(inital capacity)和负载系数(load factor)。初始容量指定了初始 table 的大小,负载系数用来指定自动扩容的临界值。当 entry 的数量超过 capacity*load_factor 时,容器将自动扩容并重新哈希。对于插入元素较多的场景,将初始容量设大可以减少重新哈希的次数。
将对象放入到LinkedHashMap或LinkedHashSet中时,有两个方法需要特别关心: hashCode() 和 equals() 。hashCode() 方法决定了对象会被放到哪个 bucket 里,当多个对象的哈希值冲突时,equals() 方法决定了这些对象是否是“同一个对象”。所以,如果要将自定义的对象放入到LinkedHashMap或LinkedHashSet中,需要@Override hashCode() 和 equals() 方法。
通过如下方式可以得到一个跟源Map迭代顺序一样的LinkedHashMap:
1 | void foo(Map m) { |
出于性能原因,LinkedHashMap是非同步的(not synchronized),如果需要在多线程环境使用,需要程序员手动同步;或者通过如下方式将LinkedHashMap包装成(wrapped)同步的:
Map m = Collections.synchronizedMap(new LinkedHashMap(...));
方法剖析
get()
get(Object key) 方法根据指定的 key 值返回对应的 value 。该方法跟 HashMap.get() 方法的流程几乎完全一样。
put()
put(K key, V value) 方法是将指定的 key, value 对添加到 map 里。该方法首先会对 map 做一次查找,看是否包含该元组,如果已经包含则直接返回,查找过程类似于 get() 方法;如果没有找到,则会通过 addEntry(int hash, K key, V value, int bucketIndex) 方法插入新的 entry。
注意,这里的插入有两重含义:
- 从
table的角度看,新的entry需要插入到对应的bucket里,当有哈希冲突时,采用头插法将新的entry插入到冲突链表的头部。 - 从
header的角度看,新的entry需要插入到双向链表的尾部。
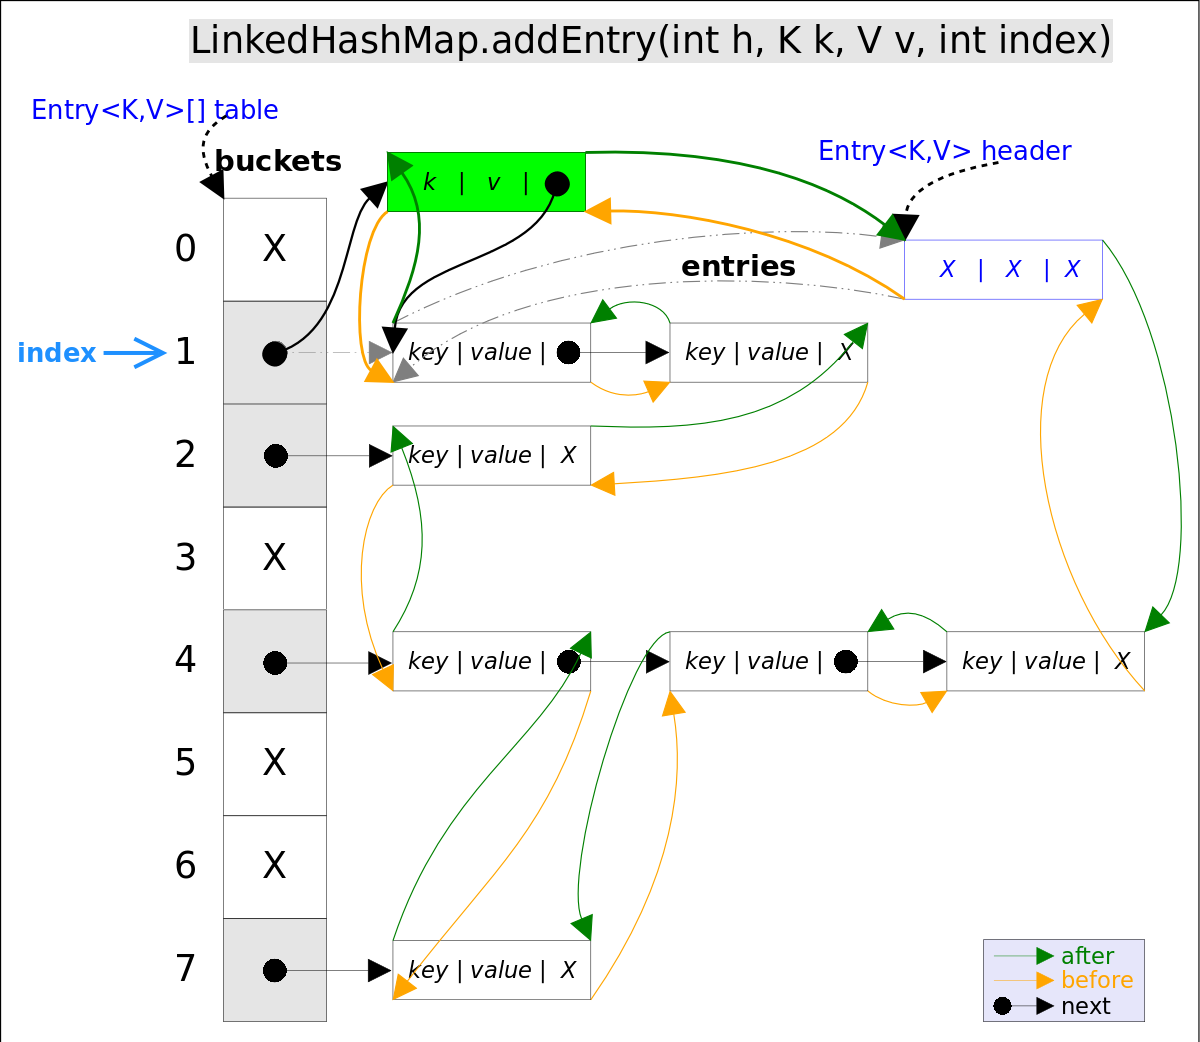
addEntry() 代码如下:
1 | // LinkedHashMap.addEntry() |
上述代码中用到了 addBefore() 方法将新 entry e 插入到双向链表头引用 header 的前面,这样 e 就成为双向链表中的最后一个元素。 addBefore() 的代码如下:
1 | // LinkedHashMap.Entry.addBefor(),将this插入到existingEntry的前面 |
上述代码只是简单修改相关 entry 的引用而已。
remove()
remove(Object key) 的作用是删除 key 值对应的 entry ,该方法的具体逻辑是在 removeEntryForKey(Object key) 里实现的。removeEntryForKey() 方法会首先找到 key 值对应的 entry ,然后删除该 entry (修改链表的相应引用)。查找过程跟 get() 方法类似。
注意,这里的删除也有两重含义:
- 从
table的角度看,需要将该entry从对应的bucket里删除,如果对应的冲突链表不空,需要修改冲突链表的相应引用。 - 从
header的角度来看,需要将该entry从双向链表中删除,同时修改链表中前面以及后面元素的相应引用。
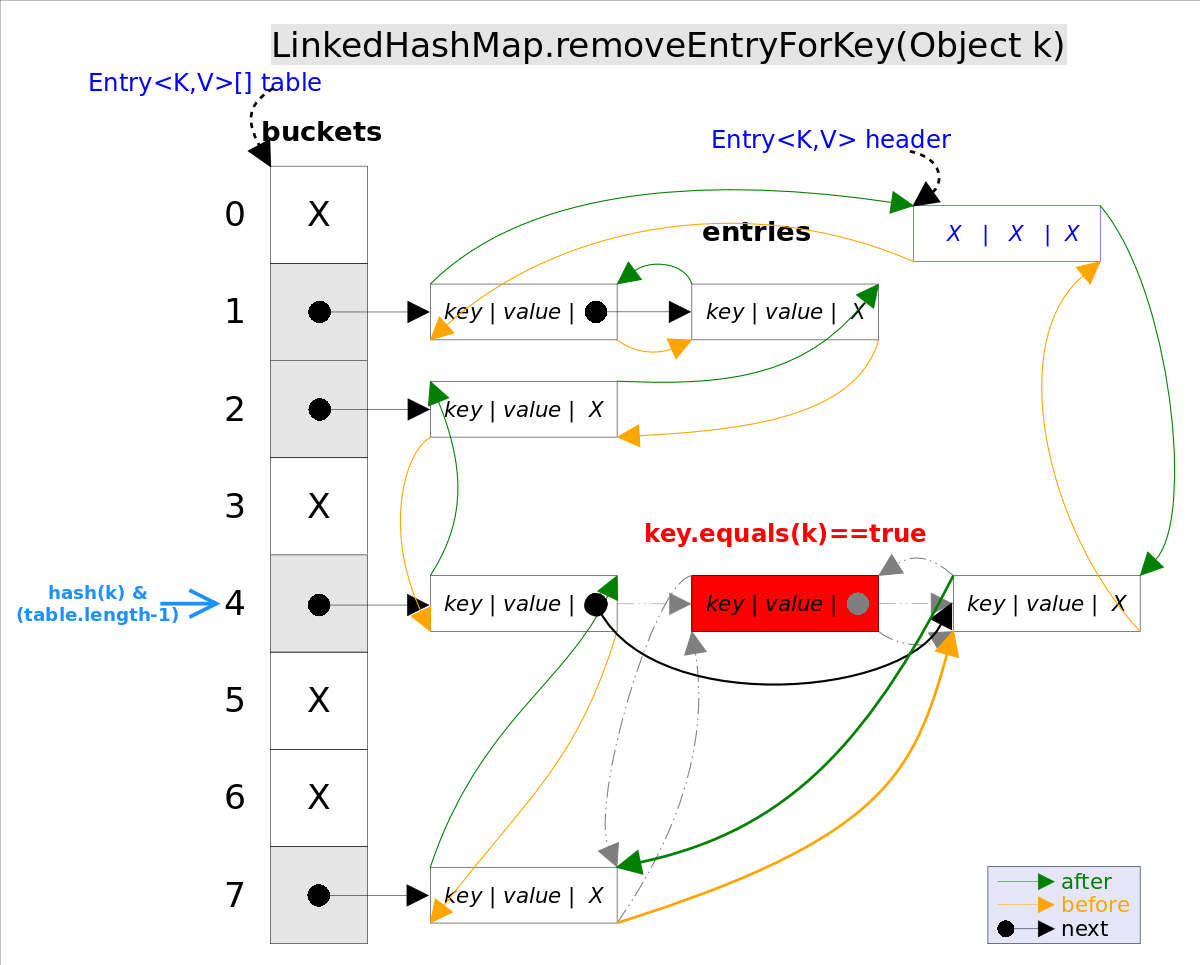
removeEntryForKey() 对应的代码如下:
1 | // LinkedHashMap.removeEntryForKey(),删除key值对应的entry |
LinkedHashSet
LinkedHashSet是对LinkedHashMap的简单包装,对LinkedHashSet的函数调用都会转换成合适的LinkedHashMap方法,因此LinkedHashSet的实现非常简单。
1 | public class LinkedHashSet<E> |